完全本地运行的「赛博 AI 女友」保姆级部署教程:不联网、不用 API Key、四个模型塞进 15G 显存
codexve·2026年7月26日·3 次浏览
本文所有组件均为开源模型,全程离线运行,你的每一句对话都留在自己的电脑里,不会上传到任何服务器。 文末提供一键安装包下载。
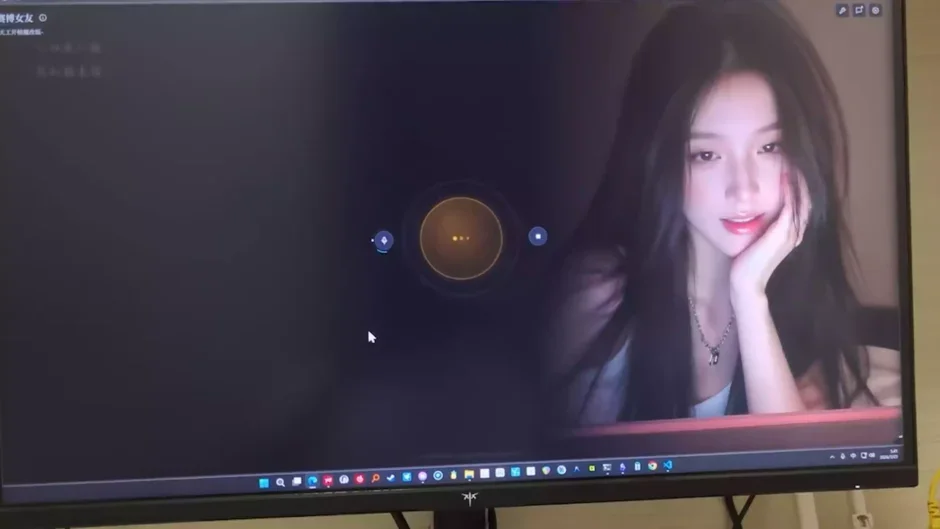
一、先说清楚这东西是什么
最近 X 上有个 Demo 挺火:一个能听你说话、实时用真人音色回应你、还能随时打断的「AI 女友」,全程不联网、不用任何 API Key。 我把它复现出来了,顺便把踩过的坑都记下来。先说结论: 这不是某个软件装上就能用,而是把四个 AI 模型拼成一条流水线。 网上很多所谓的「AI 女友」教程,本质是调用云端 API——你说的每句话都发到了别人服务器上。而这套方案是真正的本地部署:拔了网线照样能聊。 你最终会得到:
- 🎤 对着麦克风说话 ,它能听懂(不用打字)
- 🗣️ 用你指定的音色回应 (3 秒音频就能克隆一个音色)
- ✂️ 可以随时打断它 ,就像跟真人说话一样
- 🔒 完全离线 ,断网可用,无任何数据外传
- 🔄 随时热切换 人格和音色,不用重启
可能跟多人不知道怎么本地部署,其实没必要绞尽脑汁想办法,直接丢给 Claude ,让AI帮你部署即可!
本地部署安装包:
【 点击下载 】 或 【高速下载】
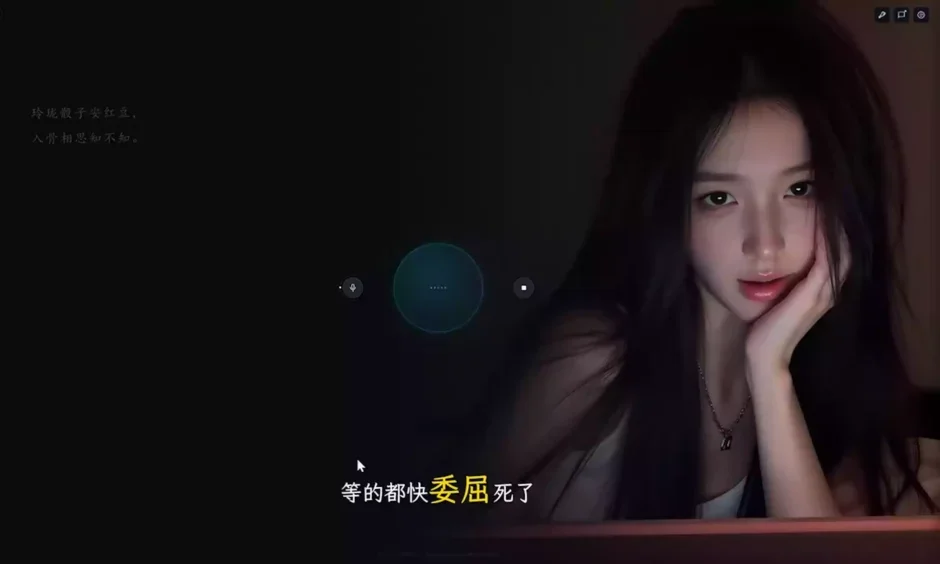
二、原理:四个模块串成一条流水线
小白最容易犯的错,是把它想象成”一个 AI”。其实是 四个各司其职的模型接力 :
你说话
 ↓
① VAD 判断"你说完了没" ← Silero VAD v5
 ↓
② STT 把语音转成文字 ← Whisper
 ↓
③ LLM 理解 + 生成回复文字 ← llama.cpp 跑本地大模型
 ↓
④ TTS 把文字变成语音说出来 ← Qwen3-TTS
 ↓
你听到声音
理解这四层特别重要,因为 出问题的时候你才知道去查哪一环 。后面的排错表就是按这个顺序组织的。 各模块的作用:
| 模块 | 干什么的 | 用什么 | 为什么选它 |
|---|---|---|---|
| VAD | 判断你什么时候说完了一句话 | Silero VAD v5 | 只有 2MB,跑 CPU,几乎不占资源 |
| STT | 语音 → 文字 | Whisper large-v3-turbo | 中文识别准,turbo 版速度快一倍 |
| LLM | 生成回复内容 | llama.cpp + Qwen3 | 本地跑 GGUF 模型,显存占用可控 |
| TTS | 文字 → 语音 | Qwen3-TTS | 首包延迟仅 97ms,这是能实时对话的关键 |
关于 TTS 多说两句。阿里在 2026 年 1 月 22 日开源了 Qwen3-TTS 全系列, Apache 2.0 协议,可商用 ,权重在 HuggingFace 和 ModelScope 都能下。它有三个版本:
Qwen3-TTS-12Hz-1.7B-Base—— 3 秒音频克隆音色( 本教程用这个 )Qwen3-TTS-12Hz-1.7B-VoiceDesign—— 用文字描述”捏”出一个音色Qwen3-TTS-12Hz-1.7B-CustomVoice—— 预设音色 + 情感指令控制
显存不够的可以用 0.6B 版本,效果略降但能跑。 底座项目是 HuggingFace 官方的开源项目 speech-to-speech (一个模块化的语音对话框架)。但要注意: 原版不支持 Qwen3-TTS,也不支持 llama.cpp ,这两块需要我们自己改造。我已经把改造代码写好了,文末打包下载。
三、硬件要求(先看这里,别白折腾)
这是最多人翻车的地方。四个模型要同时待在显存里,先算清楚账:
| 组件 | 占用显存 |
|---|---|
| Silero VAD | ~0(跑 CPU) |
| Whisper large-v3-turbo (fp16) | 约 1.6 G |
| Qwen3-TTS 1.7B (fp16) | 约 2.2 – 3.5 G |
| CUDA 上下文 + 缓存 | 约 1 G |
| 剩下的才是 LLM 能用的 | — |
按显卡分档:
| 你的显卡 | LLM 能上多大 | 体验 |
|---|---|---|
| 8G (3060Ti / 4060) | 7B Q4 | 勉强能跑,建议 TTS 换 0.6B |
| 12G (3060 12G / 4070) | 8B Q5 | 够用,反应正常 |
| 16G (4080S / 5070Ti) | 14B Q4 | ✅ 推荐档位,就是 Demo 里那个配置 |
| 24G (4090 / 3090) | 14B Q6 或 20B+ | 最佳体验,对话明显更聪明 |
其他要求:
- 系统 :Windows 10/11 或 Linux(Mac 用户不适用本教程,MLX 路线另说)
- 显卡 :NVIDIA,且驱动版本 ≥ 550
- 硬盘 :预留 40G 以上(模型很占地方)
- 内存 :16G 起步,32G 更稳
⚠️ AMD 显卡和核显用户请止步 。这套方案依赖 CUDA,A 卡目前跑不了。
四、准备工作:装三个基础环境
4.1 安装 Python 3.10 或 3.11
注意:不要装 3.12 以上版本 ,很多依赖包还没适配,装了必踩坑。 去 python.org 下载 Python 3.11.x。 安装时 务必勾选 Add Python to PATH (下图那个复选框),漏掉这一步后面所有命令都会报”不是内部或外部命令”。 装完开一个命令行验证:
python --version显示 Python 3.11.x 就对了。
4.2 安装 Git
去 git-scm.com 下载安装,一路下一步即可。 验证:
git --version4.3 确认显卡驱动和 CUDA
命令行输入:
nvidia-smi会显示一个表格,右上角有 CUDA Version: 12.x 字样。 如果这条命令报错,说明驱动没装好 ,去 NVIDIA 官网下最新驱动重装。
五、开始部署
第 1 步:下载项目代码
新建一个目录( 路径里千万不要有中文和空格 ,这是新手最常见的死因),然后:
git clone https://github.com/huggingface/speech-to-speech
cd speech-to-speech
第 2 步:安装依赖
pip install -r requirements.txt
pip install soundfile scipy modelscope
这一步会下几个 G 的东西,耐心等。 国内网络建议先换源 :
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple然后装 Qwen3-TTS 的推理库:
git clone https://github.com/QwenLM/Qwen3-TTS
cd Qwen3-TTS
pip install -e .
cd ..
第 3 步:下载模型权重
重点:走 ModelScope(魔搭),不要走 HuggingFace。 魔搭是国内的,速度快而且不用梯子。
# TTS 模型(约 3.5G)
modelscope download --model Qwen/Qwen3-TTS-12Hz-1.7B-Base --local_dir ./models/qwen3-tts
LLM 模型去魔搭搜 GGUF 格式的,手动下载放到 models/ 目录。推荐:
- 16G 显存 →
Qwen3-14B-Q4_K_M.gguf(约 8.5G) - 12G 显存 →
Qwen3-8B-Q5_K_M.gguf(约 5.7G) - 8G 显存 →
Qwen3-7B-Q4_K_M.gguf(约 4.4G)
Whisper 模型会在第一次运行时自动下载,不用管。
第 4 步:准备参考音频(决定成败的一步)
Qwen3-TTS 靠一段参考音频来克隆音色。 这段音频的质量,直接决定你的”女友”听起来是真人还是机器人。 要求:
- ✅ 5–10 秒 (别超过 15 秒,太长反而效果差)
- ✅ 纯净人声 ,没有背景音乐、没有混响、没有杂音
- ✅ 单声道,24kHz 以上,wav 格式
- ✅ 语气要接近你想要的效果 ——参考音频平淡,克隆出来就平淡
用 ffmpeg 从任意音频裁一段并转格式:
ffmpeg -i 原始音频.mp3 -ss 00:00:12 -t 8 -ac 1 -ar 24000 voices/xiaoman.wav参数解释: -ss 00:00:12 从第 12 秒开始, -t 8 截取 8 秒, -ac 1 转单声道, -ar 24000 采样率 24kHz。
🔴 重要提醒 :三秒克隆音色这个能力很强,也很容易被滥用。 请不要未经同意克隆真人的声音 ,尤其是明星、主播或身边的人——这在很多地区已经涉及法律风险。建议用公开数据集的样本,或者自己录一段。
第 5 步:放入改造文件
把我打包的三个文件按下面的位置放好:
speech-to-speech/
├── s2s_pipeline.py ← 原有文件,待会要改
├── voice_registry.py ← 【放这里】热切换模块
├── characters.json ← 【放这里】人格配置
├── voices/
│ └── xiaoman.wav ← 【放这里】你的参考音频
├── TTS/
│ └── qwen3_tts_handler.py ← 【放这里】TTS 接入代码
└── models/
 ├── qwen3-tts/ ← 第 3 步下载的
 └── Qwen3-14B-Q4_K_M.gguf ← 第 3 步下载的
第 6 步:修改 s2s_pipeline.py (三处)
用记事本或 VS Code 打开 s2s_pipeline.py 。 改动 ① —— 在文件最上方的一堆 import 后面,加两行:
from voice_registry import VoiceRegistry, serve_panel
REGISTRY = VoiceRegistry("characters.json")
改动 ② —— 搜索 def get_tts_handler ,找到里面 elif module_kwargs.tts == "chatTTS": 这样的分支,在旁边加一段( 注意缩进要对齐 ):
 elif module_kwargs.tts == "qwen3":
 from TTS.qwen3_tts_handler import Qwen3TTSHandler
 return Qwen3TTSHandler(
 stop_event,
 queue_in=lm_response_queue,
 queue_out=send_audio_chunks_queue,
 setup_args=(should_listen,),
 setup_kwargs={
 "model_name": "./models/qwen3-tts",
 "device": "cuda",
 "registry": REGISTRY,
 },
 )
改动 ③ —— 搜索 def main ,在函数里、 ThreadManager 那行 之前 加一行:
serve_panel(REGISTRY)💡 Python 对缩进极其敏感。改完如果报 IndentationError ,就是空格数没对齐——用 4 个空格,不要用 Tab。第 7 步:先跑通原版(别跳过!)
在换 Qwen3-TTS 之前, 先用原版的简易 TTS 测一遍 ,确认你的麦克风和音响是通的:
python s2s_pipeline.py --mode local --tts melo --language zh对着麦克风说句话。 能听到回复,就说明 VAD、Whisper、音频设备三层都正常。 听不到?先查设备:
python -c "import sounddevice; print(sounddevice.query_devices())"看看默认输入输出设备是不是你想用的那个。
这一步花 5 分钟,能帮你省下几小时。跳过的话,后面出问题你根本分不清是硬件问题、原版问题、还是改造代码的问题。
第 8 步:启动 llama-swap(LLM 引擎)
我们用 llama-swap 来跑大模型。它的好处是 能按需自动切换模型 ——你在面板上换人格时,它会自动卸载旧模型加载新的,不用你操心显存。 新建配置文件 llama-swap.yaml :
models:
 qwen3-14b-q4:
 cmd: ./llama-server -m models/Qwen3-14B-Q4_K_M.gguf --port 8081 -ngl 99 -c 8192 --flash-attn
 proxy: "http://127.0.0.1:8081"
参数解释: -ngl 99 把所有层放显卡上跑(显存不够就调小,比如 -ngl 30 ), -c 8192 上下文长度, --flash-attn 省显存加速。 开一个新的命令行窗口 运行:
llama-swap --config llama-swap.yaml --listen 127.0.0.1:8080这个窗口要一直开着。 然后 再开一个窗口验证它活着 :
curl http://127.0.0.1:8080/v1/chat/completions -H "Content-Type: application/json" -d "{\"model\":\"qwen3-14b-q4\",\"messages\":[{\"role\":\"user\",\"content\":\"你好\"}]}"有 JSON 返回就对了(第一次要等 10–30 秒加载模型,正常)。
⚠️ 这一步不通,就不要往下走。 否则启动主程序后你会以为是 TTS 出问题,白白排查半天。 另外说明一下”不用 API Key”是怎么回事:llama-server 说的是 OpenAI 兼容协议,但它 根本不校验 key ,随便填个字符串就行。所以我们既用上了标准接口,又完全没有联网。
第 9 步:启动主程序
再开一个新窗口 (现在你有两个窗口:llama-swap 一个,主程序一个):
python s2s_pipeline.py ^
 --mode local ^
 --stt whisper --stt_model_name openai/whisper-large-v3-turbo ^
 --llm open_api ^
 --open_api_base_url http://127.0.0.1:8080/v1 ^
 --open_api_api_key local ^
 --open_api_model_name qwen3-14b-q4 ^
 --tts qwen3 ^
 --language zh ^
 --thresh 0.4 --min_speech_ms 300 --min_silence_ms 500
Windows 用^换行,Linux/Mac 用\。嫌麻烦就把整条命令写成一行。
启动时你应该 按顺序 看到这几条日志:
Silero VAD loaded
Whisper loaded
Qwen3-TTS loaded: ./models/qwen3-tts on cuda
Warming up Qwen3TTSHandler
切换面板: http://127.0.0.1:8900/
看到面板地址,就成功了。 对着麦克风说话试试。
第 10 步:热切换面板
浏览器打开 http://127.0.0.1:8900/ ,会看到一个深色的角色列表,点一下就切换。
- 换音色 —— 瞬间生效(模型常驻显存,只换参考音频)
- 换人格 —— 瞬间生效(换 system prompt)
- 换 LLM —— 需要等几十秒(llama-swap 在卸载重载模型)
六、自定义你的「女友」
打开 characters.json ,你会看到类似这样的结构:
{
 "xiaoman": {
 "label": "小满 · 温柔向",
 "ref_audio": "voices/xiaoman.wav",
 "llm_model": "qwen3-14b-q4",
 "system_prompt": "你叫小满,25岁。性格温柔,偶尔小小地毒舌一下。..."
 }
}
想加新角色,照着复制一份改就行。 但有个坑必须讲清楚 : system_prompt 里那几条说话规则 不是啰嗦,是必需的 。 因为大模型默认会输出 Markdown、编号列表、emoji、 (轻轻笑了笑) 这种动作描写——而 TTS 会把这些逐字读出来 。你会听到你的”女友”一本正经地念:”一、点、我很开心、括号、轻轻笑了笑、括号”。 所以这几条必须保留:
1. 每次回复不超过两句话,总共不超过40个字。
2. 用日常口语,不用书面语。禁止使用 markdown、列表、编号。
3. 禁止输出任何 emoji、颜文字、括号内的动作描写。
4. 不要复述我的问题,直接回应。
5. 数字用中文写(说"三点"不说"3点"),否则语音合成会读错。
第 1 条尤其关键。不限制长度的话,模型会输出一大段,TTS 一读就是三十秒—— 这是体验崩掉的头号原因 。
七、常见问题排错表
按前面讲的四层流水线顺序排查,一查一个准:
| 现象 | 大概率原因 | 怎么修 |
|---|---|---|
| 说话完全没反应,日志无输出 | VAD 阈值太高 | --thresh 从 0.4 降到 0.3 |
| 环境噪音也能触发 | VAD 阈值太低 | --thresh 升到 0.5 |
| 有识别文字,但没有回复 | llama-swap 没通 | 回第 8 步 curl 验证 |
| 有回复文字,但没声音 | 参考音频路径错 / qwen_tts 没装 | 检查路径; pip list | findstr qwen |
| 声音尖锐、像开了 1.5 倍速 | 重采样没生效 | 确认装了 scipy |
| 说完一句就再也不理你了 | 麦克风没被交还 | 看日志有无异常报错 |
CUDA out of memory | 显存不够 | LLM 量化降一档,或 TTS 换 0.6B |
| 第一句话卡 3 秒 | 预热没跑完 | 正常现象,第二句起就快了 |
IndentationError | 第 6 步缩进改错了 | 用 4 个空格,别用 Tab |
各种 ModuleNotFoundError | 依赖没装全 | 重跑第 2 步 |
调 VAD 参数的建议: --thresh 在 0.35–0.45 之间试, --min_silence_ms 500 左右。 这个一定要在你自己的麦克风上实测调整 ,每个人的收音环境差别很大。
八、一点说明
关于代码兼容性 :Qwen3-TTS 开源才半年,官方 API 还在迭代。我在 qwen3_tts_handler.py 里特意把推理调用隔离在 _synth() 一个方法里——如果哪天官方接口变了,你只需要改那几行,不用动其他地方。跑之前建议对一下 官方仓库 的最新 README。 关于这类应用 :技术本身很有意思,能把语音识别、大模型、语音合成三样东西在一台家用电脑上串起来,几年前还是不可想象的事。但也提醒一句——它终究是个概率模型在生成文字,别把它当成真实的情感关系来投入。当个有趣的技术玩具,或者当成学习本地 AI 部署的实战项目,才是它最合适的位置。
九、资源下载
- 改造文件包 (含
qwen3_tts_handler.py、voice_registry.py、characters.json):见下方下载链接 - 底座项目:https://github.com/huggingface/speech-to-speech
- Qwen3-TTS:https://github.com/QwenLM/Qwen3-TTS
- llama-swap:https://github.com/mostlygeek/llama-swap
- 模型下载
部署过程遇到问题,欢迎在视频的评论区留言,把 报错的完整日志 贴出来,我看到会回复。 本教程所涉及的模型均为开源协议,可自由使用。声音克隆请在获得授权的前提下进行。